AIに入力してはいけない機密情報は5つ!入力の判断基準と安全な使い方を紹介

「この資料、生成AIに貼っても大丈夫だろうか…」業務で生成AIを使っていれば、一度は迷ったことがあるはずです。日本企業の55.2%が業務で生成AIを利用している一方、活用方針を決めていない企業は50.9%にのぼります。何を入力してよいかの判断は、現場の一人ひとりに委ねられたままです。2026年9月には、社員が顧客の疾患情報を私用の生成AIにアップロードした事例も公表されました。
本記事では、生成AIに入力してはいけない機密情報を5つに分類し、実際に起きた5つの事例、入力してよいかを決める3つの判断基準、機密情報を扱う業務で安全に使う4つの手段を解説します。
目次
- 生成AIに機密情報を入力すると何が起きるのか
- 生成AIに入力してはいけない機密情報5分類
- 機密情報の入力で実際に起きたこと5選
- 入力してよいかを決める3つの判断基準
- 機密情報を扱う業務で安全に使う4つの手段
- 機密情報を扱う業務の生成AI活用は、スパイクスタジオへ
生成AIに機密情報を入力すると何が起きるのか
生成AIに機密情報を入力してはいけない理由をきちんと理解している方はどれくらいいるでしょうか。
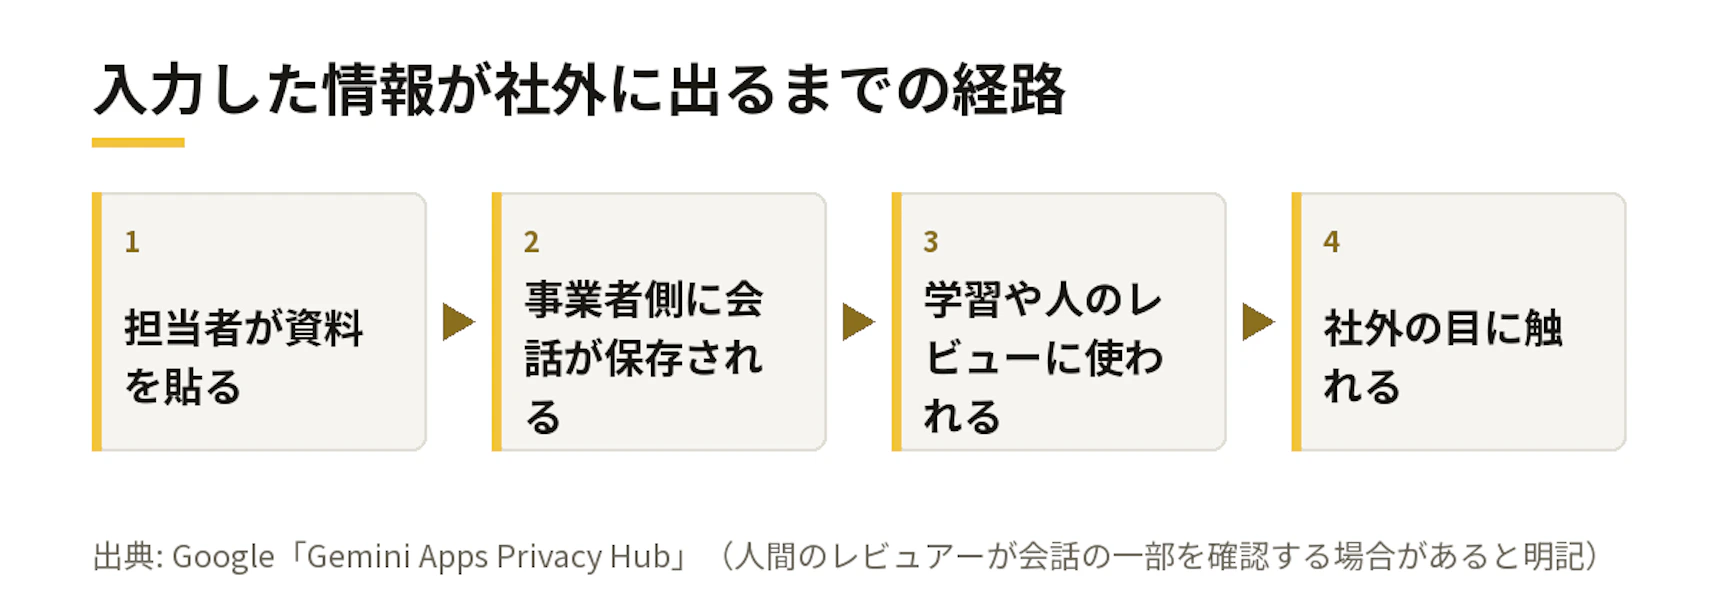
生成AIに入力した内容は、チャット履歴を削除しても、サービス側に一定期間残る場合があります。サーバーに保存され、学習や品質改善に使われることがあります。そして社外に流出してしまうリスクがあります。ここでは、どういった経路で情報が社外に出る可能性があるのかを押さえます。
入力した情報が社外に出る4つの経路
まとめると、4つの経路が想定されます。
1. 学習利用|入力した内容が、モデルを訓練するデータに使われる
2. 人によるレビュー|品質改善のため、事業者側の担当者が会話の一部を読む
3. ログの保持|会話が一定期間、事業者のサーバーに残る
4. 共有リンク|共有した会話が、意図しない相手から見える状態になる
「学習に使われなければ安全」ではない点が重要です。Google は Gemini の公式ヘルプで、人間のレビュアーが会話の一部を確認すると説明したうえで、「レビュアーに見られたくない情報や、Google にサービス改善へ使ってほしくない機密情報は入力しないでください」と明記しています(Gemini Apps Privacy Hub(Google、2026年9月24日更新))。また、会話は設定が有効な場合に既定で18か月保持され、レビューを経た会話はアカウントの履歴を削除したあとも最長3年間、アカウントと切り離した形で残ります。
AIのセキュリティ懸念はあるのに、ルールは半数の企業で決まっていない
総務省「令和7年版情報通信白書」によると、日本企業で何らかの業務に生成AIを利用していると回答した割合は55.2%でした。導入にあたっての懸念事項は、1位が「効果的な活用方法がわからない」、2位が「社内情報の漏えい等のセキュリティリスク」です(総務省「令和7年版 情報通信白書」企業におけるAI利用の現状、2025年)。
一方、AI利用に関するルールの整備は追いついていません。東京商工リサーチが2025年7月30日〜8月6日に実施した調査(有効回答6,645社)では、生成AIの活用方針を「決めていない」企業が50.9%、活用を推進している企業は25.2%でした(東京商工リサーチ「『生成AI』活用は企業の25%にとどまる」2025年8月)。
この状態では、AIを使いたくても、使う人の側の不安は残ったままです。業務で生成AIを利用している1,365人への調査では、「生成AI活用において感じているリスク」を聞いたところ、39.8%が「回答の精度」、37.2%が回答を引き出す指示の難しさ、そして、34.9%が「機密情報の漏洩リスク」を挙げました(スマートキャンプ「BOXIL」実態調査、2025年12月実施、n=1,365)。また、同じ調査で、会社が未導入でも個人で使っている層が14.4%いることと合わせると、ルールが無いまま各自の判断で使われている状態が見えてきます。会社が把握していない利用については、シャドーAIの事例6選で詳しく扱っていますので、あわせてご覧ください。
生成AIに入力してはいけない機密情報5分類
「機密情報」とひとまとめにすると判断しづらくなります。情報の種類ごとに、何が起きるのかが違うからです。まず全体像を示します。
| 分類 | 具体例 | 入力すると起きること | 代わりの渡し方 |
|---|---|---|---|
| ①顧客情報 | 取引先の社名、案件の内容、見積、要望、商談メモ | 秘密保持義務の違反になりうる。委託・第三者提供にあたる場合がある | 社名と金額を記号に置き換え、構造だけ渡す |
| ②個人情報 | 氏名、連絡先、マイナンバー、保険証番号、疾患・健康情報 | 本人の同意なく外部で扱われると個人情報保護法違反となる可能性がある | そもそも入力しない。集計は社内の表計算で行う |
| ③未公開情報 | 公表前の決算数値、M&A、開発中の仕様、人事 | 営業秘密としての秘密管理性を失うおそれがある | 公表済みの数字だけを使う。仕様は一般名詞に置き換える |
| ④ソースコードと認証情報 | 自社開発のコード、APIキー、接続情報、設計書 | 社外のサーバーに自社の技術資産が渡る。認証情報は悪用されうる | 認証情報を削ったうえで、再現用の最小コードだけ渡す |
| ⑤契約情報 | NDAの対象情報、業務委託契約の条項、価格条件 | 契約上の開示禁止に触れるおそれがある | 条項の型だけを一般化して相談する |
①顧客情報|取引先名・案件・見積
顧客から預かった情報は、自社のものではありません。取引先との契約に秘密保持の条項があれば、外部の生成AIに貼った時点で開示にあたる可能性があります。
個人情報を含む場合はさらに重くなります。個人情報保護委員会は、クラウドサービスの利用が「個人データを取り扱わないこととなっている場合」に当たらなければ、第三者提供または委託に該当しうるとの解釈を示しています(個人情報保護委員会「株式会社エムケイシステムに対する個人情報の保護に関する法律に基づく行政上の対応について」2024年3月25日)。生成AIサービスへの入力も、外部のクラウドに個人データが渡るという構造は同じです。
②個人情報|氏名・連絡先・要配慮個人情報
個人情報保護委員会は2023年、注意喚起で、本人の同意を得ずに個人データを含むプロンプトを入力し、そのデータが「応答結果の出力以外の目的で取り扱われる場合」、個人情報保護法の規定に違反することとなる可能性があると明記しました(個人情報保護委員会「生成AIサービスの利用に関する注意喚起等について」2023年6月2日)。
病歴や健康診断の結果などの要配慮個人情報は、取得の時点で原則として本人の同意が必要です。扱いを誤ったときの影響がもっとも大きい分類です。実際に起きた事例は、次の章で取り上げます。
③未公開情報|公表前の数字・開発中の仕様
公表前の決算数値、M&Aの検討状況、開発中の製品仕様、人事情報がここに入ります。
見落とされがちなのが、不正競争防止法との関係です。経済産業省は、営業秘密として保護を受けるには「秘密管理性」「有用性」「非公知性」の3要件をすべて満たす必要があると説明しています(経済産業省「営業秘密~営業秘密を守り活用する~」)。社内で厳重に管理してきた情報を、社員が個人のアカウントで外部サービスに入力できる状態なら、秘密として管理されていたと言えるかが問われます。漏れたときの損害だけでなく、法的な保護そのものを失う可能性があります。
④ソースコードと認証情報
自社開発のコードは技術資産です。加えて、コードの中には接続情報やAPIキーが埋まっていることがあります。エラーの原因を調べてもらおうとコードを丸ごと貼ると、APIキーなどの認証情報も一緒に渡すことになります。
この分類で最も知られているのが、次章で取り上げるサムスン電子の事例です。開発の現場では「動かないコードを早く直したい」という動機が強く働くため、禁止だけでは止まりにくい分類でもあります。
⑤契約情報|NDAの対象・価格条件
秘密保持契約(NDA)を結んでいる相手の情報は、契約で開示先が限定されています。生成AIへの入力が「開示」にあたるかは契約の文言によりますが、第三者のサービスにデータが渡る以上、安全側に倒すのが実務です。
価格条件も同じです。取引先ごとの単価は、他社に伝われば交渉上の不利益に直結します。契約書のレビューを生成AIに頼みたい場合は、相手の社名・金額・固有の条件を外し、条項の型だけを相談してください。
機密情報の入力で実際に起きたこと5選
ここからは、機密情報の入力で実際に起きた事例を5件紹介します。生成AI全般のトラブルについては生成AIの問題事例13選にまとめているので、あわせてご覧ください。
①ソースコードの問題事例|サムスン電子でコード入力後に全社利用を禁止
2023年4月、サムスン電子のエンジニアが、プログラムのエラーを解消するために社内のソースコードを ChatGPT に入力しました。社外秘の情報が外部のサーバーに渡ったことになります。
同社は2023年5月1日付で、会社支給の端末での生成AI利用を一時的に禁止する通達を出しました。違反した場合は解雇を含む懲戒の対象になるとしています。社内調査では、回答者の65%が生成AIの利用にセキュリティ上の懸念があると答えていました(Bloomberg、2023年5月2日)。
②要配慮個人情報の問題事例|RIZAPで疾患情報を私用AIに誤アップロード
2026年9月3日、RIZAP は、社員が顧客の個人情報を外部の生成AIサービスに誤ってアップロードしたと公表しました。
健康経営・保険者事業部の社員が、特定保健指導の対象者データを集計する作業の途中で、個人で使っている生成AIサービスにファイルを送信したものです。含まれていたのは氏名、生年月日、保険証の記号番号、メールアドレス、一部の住所と電話番号に加え、高血圧症や糖尿病などの要配慮個人情報でした。同社は発覚後にチャット履歴を削除して学習利用を停止し、個人情報保護委員会への報告を済ませたとしています(ITmedia NEWS、2026年9月4日)。
会社が与えた環境ではなく、社員が個人で使っているサービスが経路になった点が、この事例の要です。
③社内資料の問題事例|Amazonが社内資料に酷似した回答を確認
2023年1月、Amazon の顧問弁護士チームが社内のチャットで、ChatGPT の回答が同社内の既存資料に酷似していた例があるとして、従業員に注意を促しました。開発中のコードを含む機密情報を ChatGPT と共有しないよう求めた内容です(Forbes、2023年5月2日)。
入力した情報が他人の回答に現れうるという懸念が、企業側から具体的に示された早い例にあたります。
④規制側の問題事例|イタリア当局がChatGPTの個人データ処理を一時停止
2023年3月20日、ChatGPT のバグにより、一部の利用者の氏名・メールアドレス・クレジットカード番号の下4桁などが他の利用者に表示されました。
これを受けてイタリアのデータ保護当局(Garante)は、同月末、個人データの収集に適切な法的根拠がないことや年齢確認の不備を理由に、イタリア国内での処理を即時に制限するよう命じました。OpenAI は同国でのサービス提供を一時停止し、プライバシー通知の追加やオプトアウト権の整備といった是正を行ったうえで、4月28日に再開が認められています(Clifford Chance、2023年4月)。
自社の運用に落ち度がなくても、サービス側の事情で使えなくなることがあると分かります。
⑤共有機能の問題事例|ChatGPTの共有リンク約4,500件が検索結果に
2025年7月30日、ChatGPT の共有リンクが Google の検索結果から読める状態になっていると、米 Fast Company が報じました。当時 OpenAI が試験導入していた「この会話を検索で見つけられるようにする」という共有オプションが原因です。
同誌が Google のサイト内検索で数えたところ、約4,500件の会話が結果に現れました。多くは個人を特定できる情報を含まないものの、すべての会話がインデックスされるとは限らないため、実際はこれより多い可能性があるとしています(Fast Company、2025年7月30日)。同じ現象はTechCrunchも翌31日に報じています。
OpenAI の最高情報セキュリティ責任者 Dane Stuckey 氏は7月31日、意図しない共有が起きる余地が大きすぎる機能だったとしてこのオプションを削除したこと、検索エンジン側にインデックスされた内容の削除を進めていることを明らかにしました(Fast Company、2025年8月1日)。
学習に使われるかどうかとは別に、共有機能の設計ひとつで会話が外に出ることを示した事例です。
入力してよいかを決める3つの判断基準
個別の情報ごとに悩むと、判断する人によって結論が変わります。基準を3つに固定してください。3つすべてに「はい」と答えられないものは入力しない、という決め方です。
基準1|個人データが「応答以外の目的で使われないか」を確認できているか
個人情報保護委員会は、個人データを含むプロンプトを入力する場合、利用目的の範囲内であることの確認と、提供事業者が機械学習に利用しないことの確認を求めています(個人情報保護委員会「生成AIサービスの利用に関する注意喚起等」2023年6月2日)。
確認の対象は、使っているサービスの契約条件です。「たぶん大丈夫」ではなく、公式の記載で確かめられるかどうかで判断します。
基準2|営業秘密の「秘密管理性」を壊していないか
社外秘として扱ってきた情報を、個人のアカウントで外部サービスに入力できる状態のまま放置すると、秘密として管理されていたという前提が揺らぎます。経済産業省が示す3要件のうち、秘密管理性は運用でしか満たせません。
判断の目安は「この情報は、社内の誰でも見られる場所に置いてよいか」です。置けないものは、外部の生成AIにも貼れません。
基準3|使っているプランが、既定で学習に使わないと公式に明記しているか
同じサービスでも、個人向けと法人向けでデータの扱いが違います。見るべきは公式のポリシーページで、人づての説明ではありません。次の章で4サービスの記載を整理します。
機密情報を扱う業務で安全に使う4つの手段
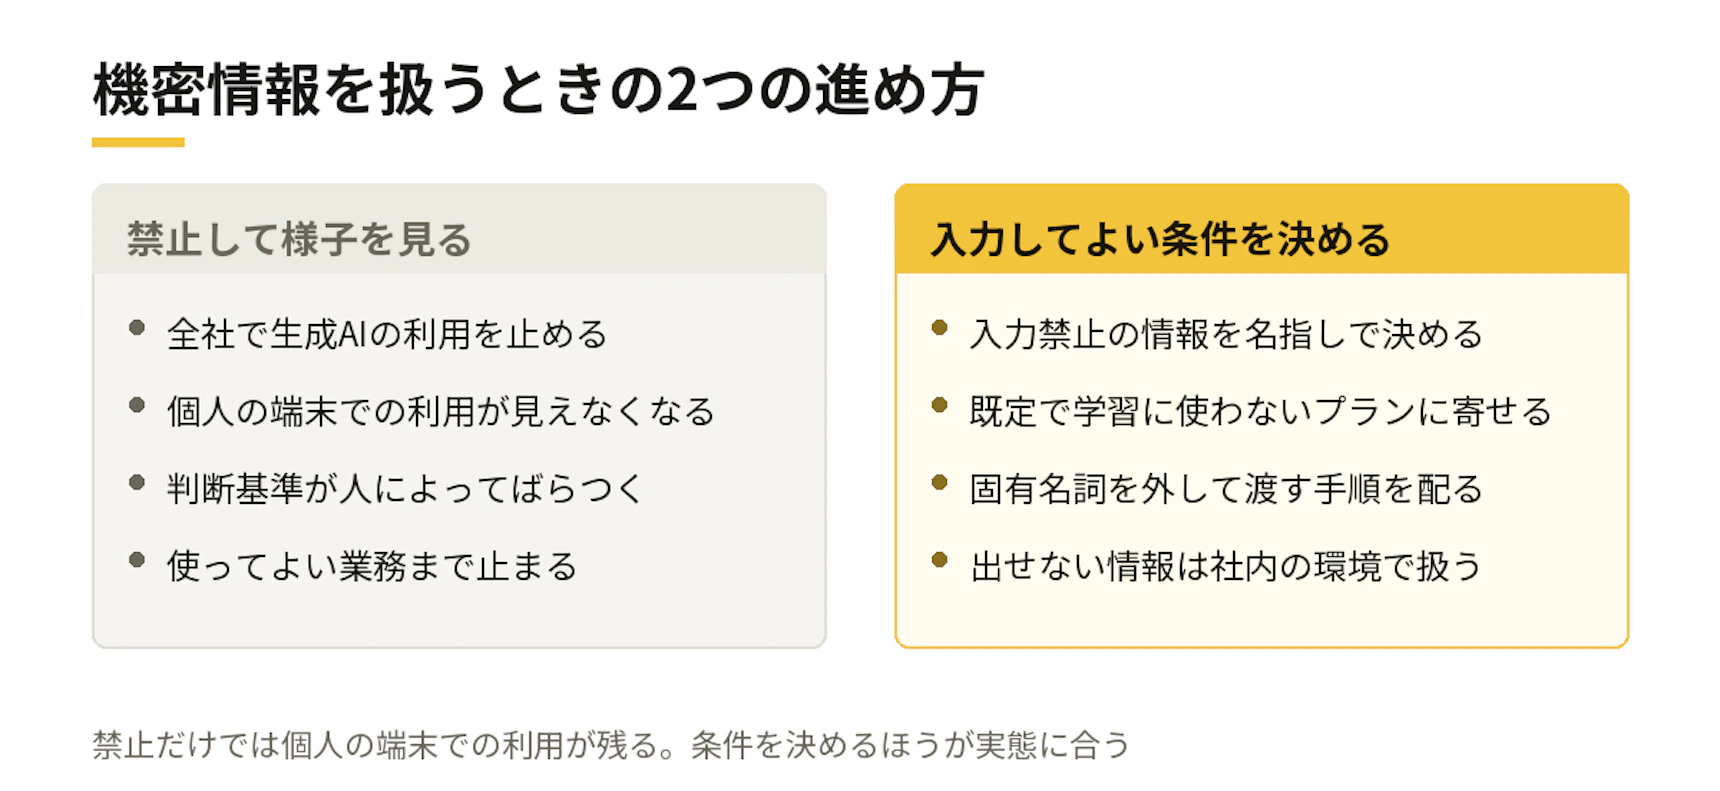
禁止は対策ではありません。使える形に変えるほうが、結果として漏れるリスクを下げられます。順番に4つ示します。
①法人向けプランとAPIに寄せる
個人向けのまま業務で使っている状態は、ここで止められます。OpenAI・Anthropic・Microsoft は、法人向けプランとAPIについて「既定では学習に使わない」と公式に明記しています。Google は職場・学校アカウントを別のポリシーで扱います。公式の記載は次のとおりです。
| サービス | 個人向けプランの既定 | 法人向け・APIの既定 |
|---|---|---|
| OpenAI(ChatGPT) | 個人ワークスペースの Free・Plus・Pro はデータ共有が既定で有効。設定の Data Controls にある「Improve the model for everyone」でオフにできる(OpenAI 公式ヘルプ) | ChatGPT Business・Enterprise・Edu と API は既定で学習に使わない(OpenAI「Enterprise privacy」) |
| Google(Gemini) | 18歳以上は「Keep Activity」が既定でオン。会話は既定で18か月保持され、人によるレビューの対象になりうる(Google 公式ヘルプ) | 職場・学校アカウントは、この設定を管理者が管理する(Google 公式ヘルプ)。Google Workspace と Vertex AI は別のポリシーが適用される(Gemini Apps Privacy Hub) |
| Anthropic(Claude) | Free・Pro・Max は、学習に使うかどうかを利用者が選ぶ方式。許可した場合は非識別化した形で最大5年間保持され、許可しない場合は削除から30日で消去される(Anthropic 公式発表、2025年8月28日) | Claude for Work・Enterprise と API は既定で学習に使わない(Anthropic Privacy Center) |
| Microsoft(Copilot) | 個人の Microsoft アカウントで使う場合は、別のポリシーが適用される | 組織の Entra ID アカウントでサインインした Microsoft 365 Copilot と Copilot Chat は、プロンプトと応答を基盤モデルの学習に使わない(Microsoft Learn「Enterprise data protection」) |
表の内容は、各社の公式ページを2026年10月に確認した時点の記載です。各種最新情報は公式サイトでご確認ください。
法人向けに寄せると、第1章で紹介した入力した情報が社外に出る4つの経路のうち「学習利用」を防ぐことができます。ただし、学習に使われないことと、誰も見ないことは別です。OpenAI は API について、入力と出力を不正利用の監視のために原則として最大30日間保持すると説明しています(OpenAI「Enterprise privacy」)。人によるレビューとログの保持、そして共有リンクは、プランの変更では消えません。保持期間の設定と、共有機能を使うときの決めごとで詰めてください。
個人向けプランでの設定の変え方は、『ChatGPTに学習させない(オプトアウト)設定方法』で手順をまとめています。
②入力を禁止する情報を2つだけ先に決める
ルールを網羅的に作ろうとすると、いつまでも完成しません。まず「個人情報」と「公表前の数字」の2つだけを名指しで禁止してください。この2つは判断に迷う余地が小さく、事故が起きたときの影響が大きい分類です。
残りの3分類は、2つの運用が回り始めてから足します。方針を決めていない企業が50.9%という調査結果を踏まえると、完璧な規程より先に、短い禁止事項が要ります。
③固有名詞を外して渡す
多くの業務は、固有名詞がなくても成立します。「A社の見積」ではなく「製造業向け、年間契約、数量3段階の見積」と書けば、同じ助言が得られます。
手順にすると、次の3つです。
- 社名・人名を記号に置き換える
- 金額を倍率や範囲に置き換える
- 資料そのものではなく、聞きたいことだけを書く
ちなみに、エクセルの表やデータは、AIがそのまま理解しづらい構造です。AIが読み取りやすいデータの渡し方については、『生成AIが読みやすいExcelシートの作り方』で具体例を紹介しています。
④外に出せない情報は、社内に閉じた環境で扱う
ここまでの3つは「渡し方」の工夫です。ただし、渡し方では解けない業務があります。図面、設計、積算のように、情報そのものが競争力で、抽象化すると仕事にならない領域です。
この領域は、気をつけて貼るのではなく、貼らずに使える形へ置き換えるのが現実的です。自社のデータを自社の環境で扱うAIエージェントを用意すれば、外部サービスに送る必要がなくなります。
スパイクスタジオのZUNOは、業務特化型のエージェントを開発するサービスで、図面・設計・積算といった専門業務を得意としています。自社の設計ルールやこれまでの判断基準、過去のデータを活用し、御社の業務に特化したAIエージェントを開発できます。熟練者の判断を社内に残しながら、実務のOJTで育てていきます。
どの業務から閉じた環境に移すべきかは、扱う情報の種類で決まります。社外に出せない情報を扱う業務のAI活用について相談するところからご支援可能です。現状の業務を整理するところから始められます。
スパイクスタジオの支援事例|トヨタ自動車さまのプロンプト勉強会
トヨタ自動車さまでは、社員が生成AIを業務で活用するための取り組みとして、プロンプト勉強会とプロンプトソンを実施しました。課題は、従業員の生成AIリテラシーにばらつきがあり、使い方が分からない人と、使ったことはあるが業務での活用イメージを持てない人が混在していたことです(弊社事例:トヨタ自動車株式会社さまの事例)。
入力してよい情報の線引きは、全社共通のルールを決めるだけでは不十分です。実際に業務を担う現場で、具体的な仕事に当てはめながら決めていくほうが定着します。
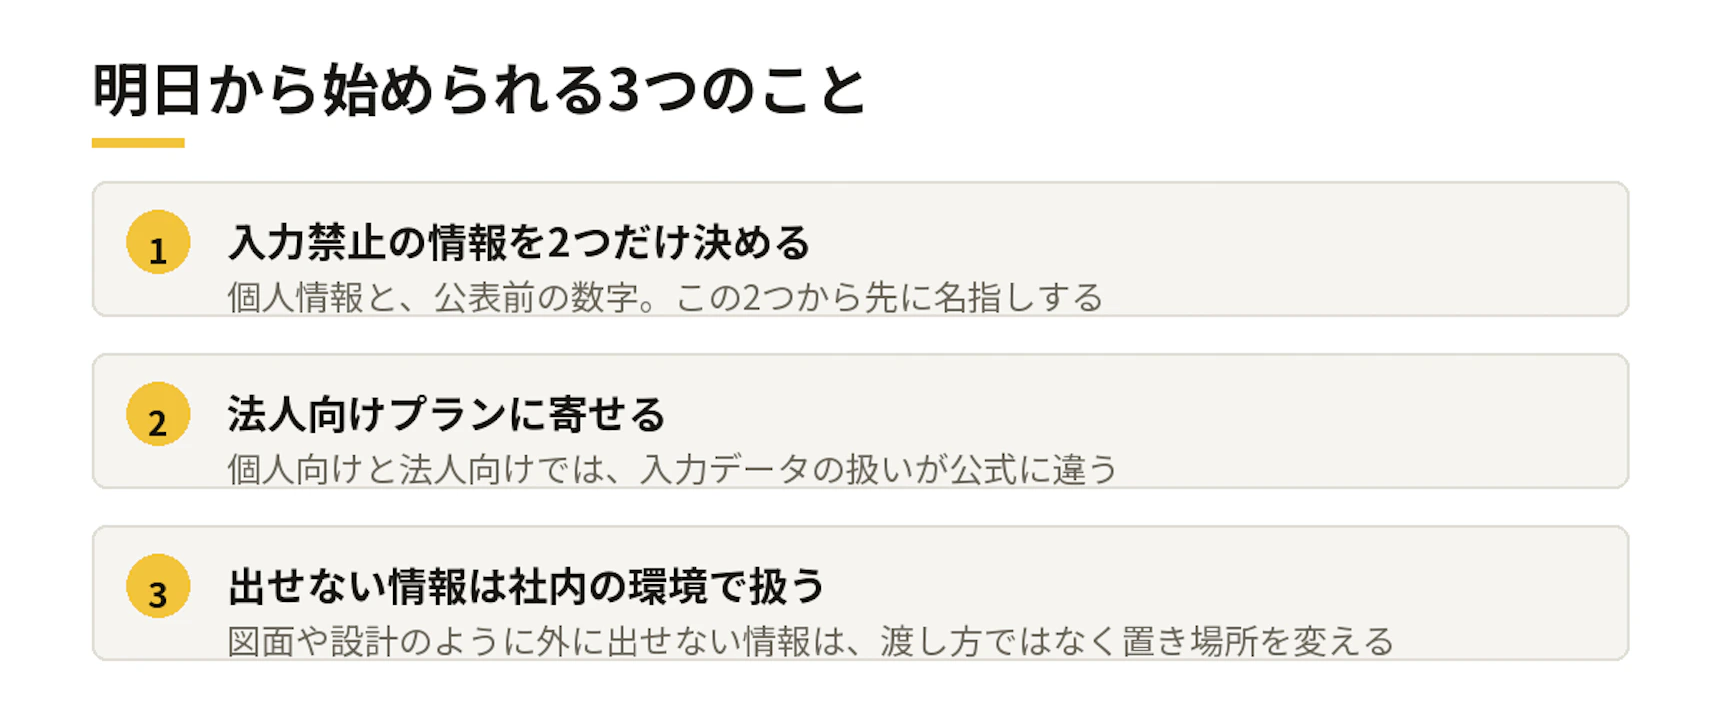
最初から完璧なルールをつくる必要はありません。禁止する情報を絞り、使うプランを見直し、扱う場所を分ける。まずはこの3つを試し、運用しながら現場に合わせて線引きを広げていくのが現実的です。
機密情報を扱う業務の生成AI活用は、スパイクスタジオへ
「何を入力してよいか」が決まらないまま使い始めると、事故が起きるか、誰も使わないかのどちらかになります。スパイクスタジオは、線引きを決めるところから、閉じた環境での実装までを支援しています。
- ZUNO|図面・設計・積算など、外に出せない情報を扱う専門業務向けの業務特化型AIエージェント
- AI人材育成|使う側・作る側・基盤層の三層に分けた研修。入力してよい情報の線引きも扱います
- BPRコンサルティング|AIを前提に業務プロセスそのものを組み替えるコンサルティング
どこから手を付けるべきか迷っている段階でも構いません。機密情報を扱う業務のAI活用について相談する。いま使っているサービスと、扱っている情報の整理からご一緒します。