ChatGPTに学習させない(オプトアウト)設定方法|仕組みや入力データの扱いを解説

「ChatGPTに入力した内容を、AIに学習させない方がいい」とは聞くもののどう設定するの?今更聞けない「AIに学習される」とはどういうこと?
この記事では、「AIが学習する」とは?という基礎の部分から、実際の設定手順、プラン別の既定、設定方法まで一度に紹介します。
業務でChatGPTを使いたい。でも入力した情報がどう扱われるか分からず踏み切れない。決裁者に「大丈夫です」と説明できる材料がない。そういった方は、ぜひご覧ください。
ただし、「履歴を消すこと」と「学習を止めること」は別の設定です。そして学習を止めても、入力した会話がその場で消えるわけではありませんので、その点には注意が必要です。
目次
- そもそも「AIに学習される」とは、何が起きることなのか
- 「オプトアウト」とは
- 入力した内容が、他の人の回答に出ることはあるのか
- ChatGPTの「学習させない」でつまずく3つの誤解
- 【手順】ChatGPTに学習させない設定方法
- プラン別|既定の扱いと、学習を止める方法
- オプトアウトにデメリットはあるのか
- 「学習させない設定」だけでは不十分|法令・社内ルールも確認する
- 【対策】業務でChatGPTを使うために決めておく3つのこと
- 生成AIの社内ルールづくりは スパイクスタジオにご相談ください
そもそも「AIに学習される」とは、何が起きることなのか
「AIに学習される」とは、入力した情報がAIの回答改善やモデル更新の材料として使われる可能性があることです。ただし、入力内容がそのまま暗記されるというより、多くのデータの一部として、言葉の使い方や回答傾向の改善に利用されるイメージです。
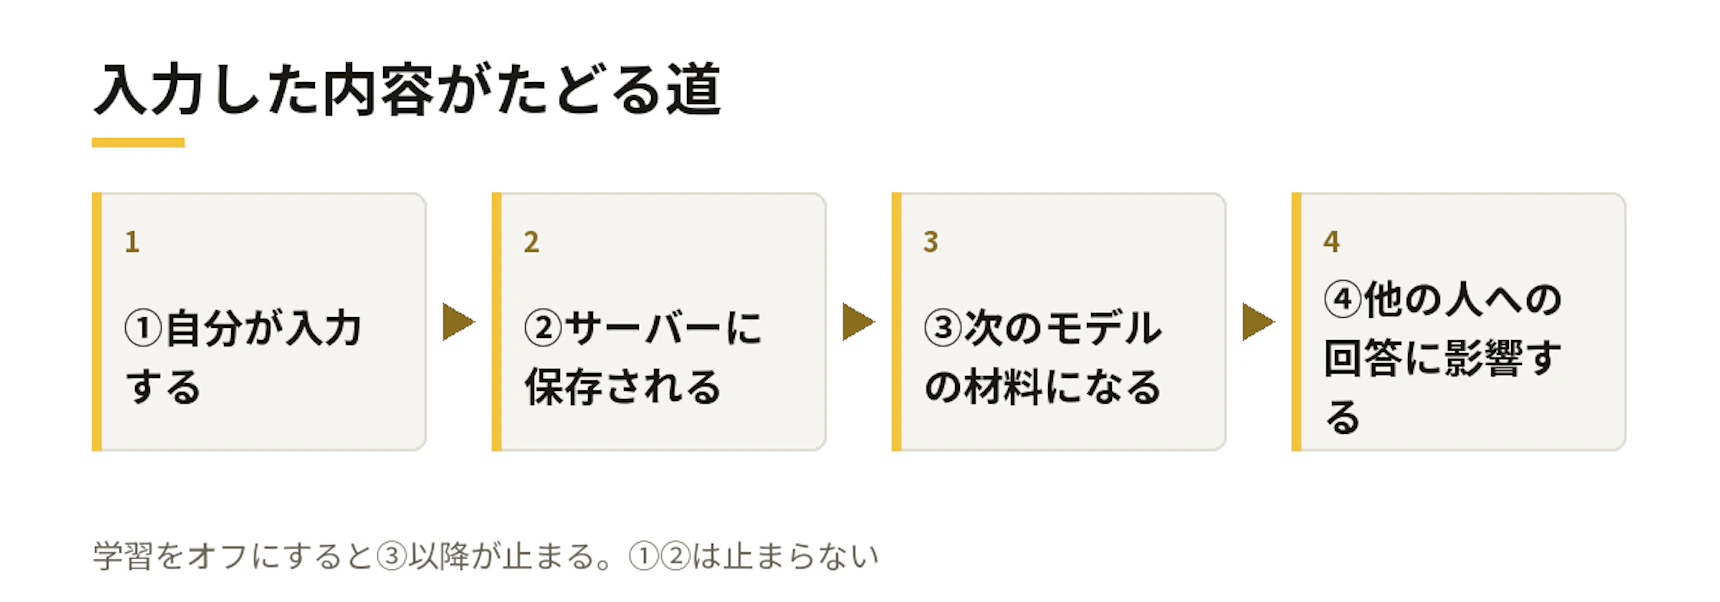
順を追うと、AIが学習するには、4つの段階があります。
そのため、個人情報や機密情報を入力する際は、サービスごとのデータ利用条件を確認し、必要であれば、「AIに学習させない設定」を行わなければなりません。
「AIに学習させない設定」は、AIが学習する4段階のステップ③を止める操作です。ステップ②は止まりません。ここが最初のつまずきどころです。学習に使われなかったとしても、入力した内容は基本的に、いったん自社の外サーバーに出ています。
AIの「学習」は、人が本を暗記するのとは違うので、言葉の定義もここで整理します。文章をそのまま保管するのではなく、言葉の並び方の傾向を数値として取り込む処理です。そのため、「入力した文章が丸ごとどこかに保管されている」わけではありません。ただし、取り込まれた傾向の中に元の文章の痕跡が残ることはあります。この点は第3章で紹介します。
AIが学習する仕組みを知らないままAIを使うことのリスクは、国内でも上位に位置づけられ始めています。IPA(情報処理推進機構)の「情報セキュリティ10大脅威 2026」では、「AIの利用をめぐるサイバーリスク」が組織向けの脅威として初めて選ばれ、3位に入りました。IPAは背景の1つとして、AIに対する不十分な理解に起因する意図しない情報漏えいを挙げています(出典: プレス発表「情報セキュリティ10大脅威 2026」を決定|IPA、2026年1月29日)。
生成AIを使う人は、すでに少数派ではありません。総務省の令和7年版 情報通信白書によれば、何らかの業務で生成AIを利用している国内企業は55.2%と半数を超えています。(出典: 企業におけるAI利用の現状|総務省 令和7年版 情報通信白書)また、個人で使ったことがある人は26.7%で、前年度調査の9.1%から3倍近くに増えました(出典: 個人におけるAI利用の現状|総務省 令和7年版 情報通信白書)。
より新しい調査でも傾向は同じです。矢野経済研究所が2025年6月末から9月初めに国内民間企業500社(有効回答496社)を対象に行った調査では、生成AIを「全社的に活用している」が11.3%、「一部の部署で活用している」が32.1%で、合わせて43.4%でした(出典: 国内生成AI/AIエージェントの利用実態に関する法人アンケート調査|矢野経済研究所(2025年12月19日))。働く人の側から見ると、パーソル総合研究所が2025年10月に実施した調査で、業務で生成AIを使っている就業者は32.4%でした(出典: 生成AIとはたらき方に関する実態調査|パーソル総合研究所(2026年2月3日))。
オプトアウトとは
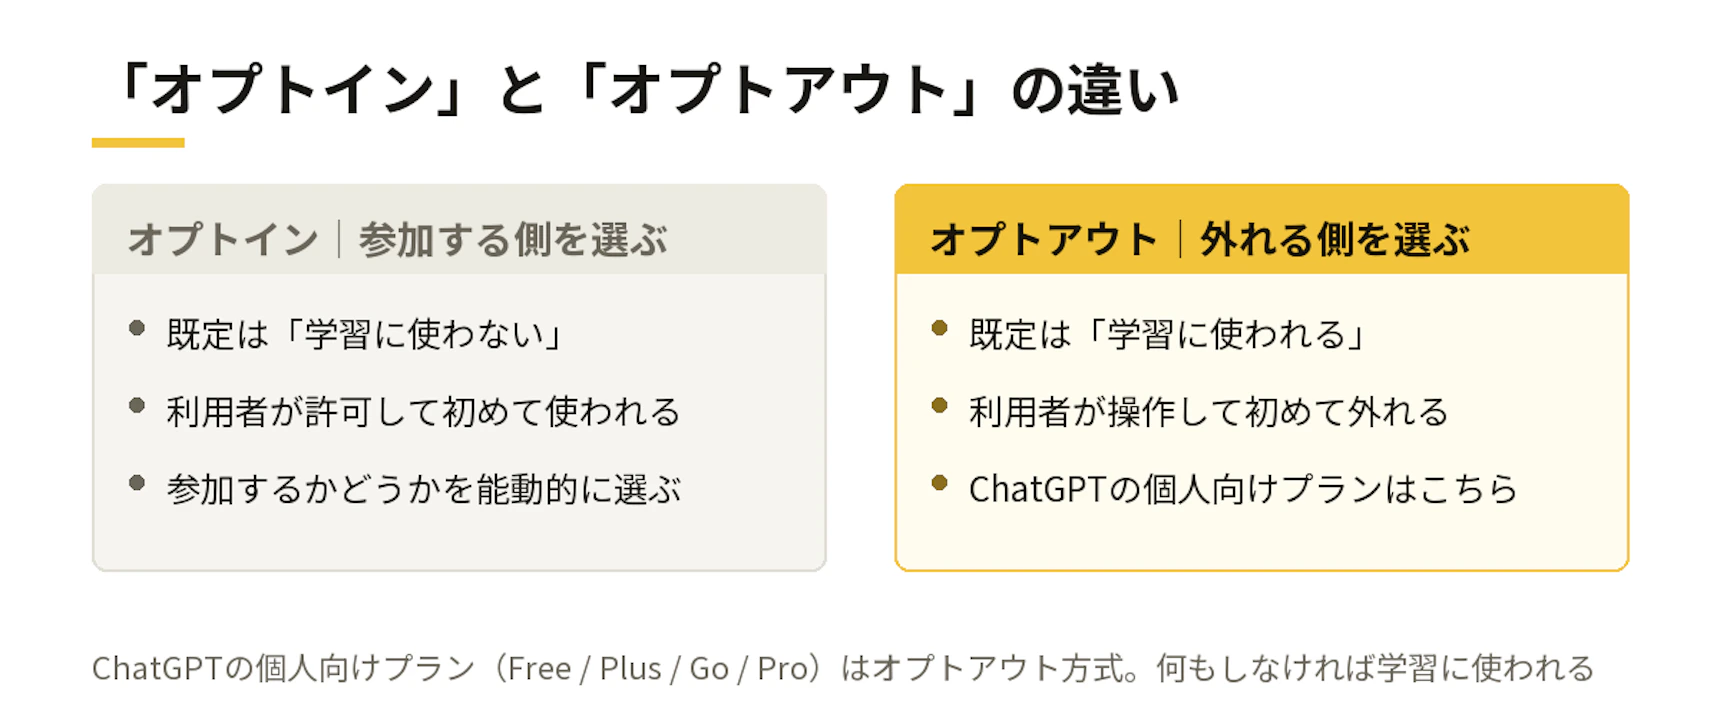
生成AIにおけるオプトアウトとは、自分が入力した内容をAIの学習対象から外すよう申し出ることです。
「オプト(opt)」は選ぶという意味です。入力した情報がサービス改善やAIの学習に利用される設定になっており、利用されたくない場合にユーザー側で拒否する方式です。一方、オプトインとは、ユーザーが明示的に許可した場合にのみ、入力データの利用を認める方式です。ChatGPTの個人向けプランは、既定で学習に使われる状態から始まります。つまり、何もしなければ学習に利用される設定なままです。もし、希望しない場合は、利用者側から拒否をする設定が必要になります。
生成AIにおけるオプトアウトの重要性
オプトアウトの主な目的は、個人のプライバシーや企業の機密情報を保持することです。普段気をつけていても、不注意から「プライバシーや機密情報に関わる質問を入力してしまった」というトラブル事例は少なくありません。
万が一、オプトアウト設定をしていなかった場合、そのデータが生成AIのモデル学習に使われることになります。それだけではなく、他者への回答として出力されてしまう可能性もあるのです。
そのため、生成AIをビジネスに活用をする場合は、特にオプトアウトを選択する必要があります。オプトアウトを申請することで、透明性のある生成AI活用が実現できるのです。
生成AIでオプトアウトが必要になる場面
次のような情報を扱うときは、オプトアウトを前提にしてください。
- 顧客名・連絡先・従業員情報といった個人情報
- 売上・原価・見積といった未公開の数字
- 設計図やソースコードなど、社外に出していない技術情報
- 秘密保持契約(NDA)の対象になっている情報
- 未発表の企画・商品・人事の情報
ただし、オプトアウトは万能ではありません。設定しても、入力した内容はいったん自社の外に出ます。この点は後半で詳しく扱います。
入力した内容が、他の人の回答に出ることはあるのか
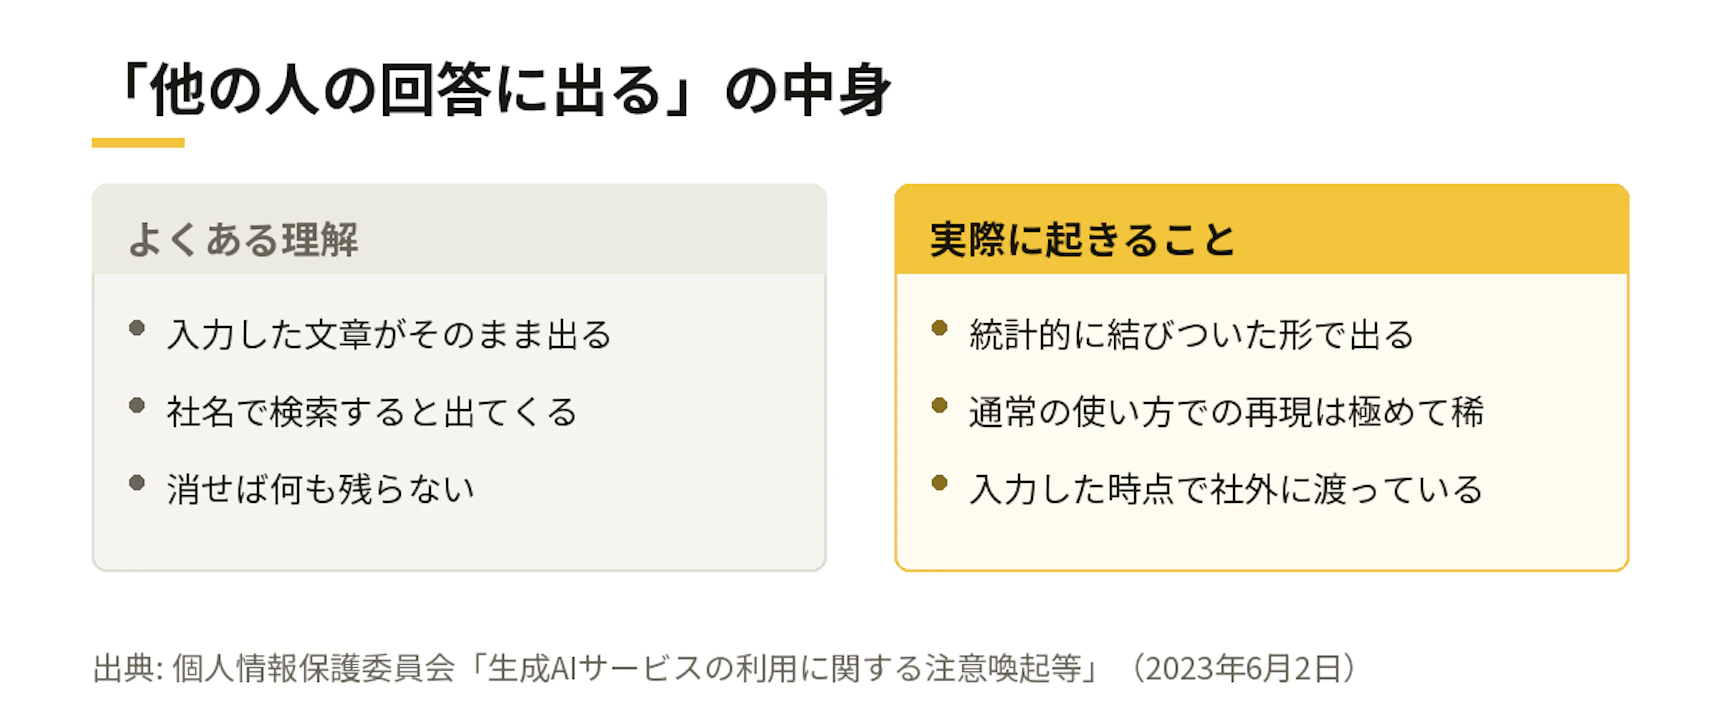
可能性はゼロではありませんが、通常は「入力した内容がそのまま他の人の回答に出る」ことは基本的に起きにくいです。
ただし「絶対に起きない」ではありません。情報が出ない場合と、起こりうる場合を分けて説明します。
情報が出ない場合|そもそも学習に使われていないとき
前の節の「③次のモデルの材料になる」が起きなければ、「④他の人の回答に影響する」は起きません。ChatGPT Business・Enterprise・Edu、そしてAPIは、既定で入力と出力を学習に使いません。OpenAIのヘルプセンターにも「既定では、ChatGPT Business・ChatGPT Enterprise・APIを含むビジネス向け製品の入力と出力を学習に使用しない」と明記されています(出典: モデルのパフォーマンスを向上させるためのデータの使用方法|OpenAIヘルプセンター)。
個人向けプランでも、設定をオフにすれば以後の会話は学習の対象から外れます。ただし1点だけ注意があります。オプトアウトの効果は、これから交わす会話に対してのものです。すでに学習に使われた分が、遡って取り消されるわけではありません。
機械学習が起こりうる場合|ただし「情報そのまま」ではない
個人情報保護委員会は2023年6月2日、生成AIを使う一般の利用者に向けた注意喚起の中で、次のように述べています。「生成AIサービスでは、入力された個人情報が、生成AIの機械学習に利用されることがあり、他の情報と統計的に結びついた上で、また、正確又は不正確な内容で、生成AIサービスから出力されるリスクがある」(出典: 生成AIサービスの利用に関する注意喚起等|個人情報保護委員会(2023年6月2日))。
大事なのは「他の情報と統計的に結びついた上で」という部分です。貼り付けた文章がそのまま表示されるのではなく、断片が他の情報と混ざった形で現れる可能性がある、という意味です。しかも、不正確な形で出ることもあります。
元の文章を取り出せることは、研究で確かめられている
「痕跡が残る」は感覚の話ではなく、実証されています。
Carlini氏らの研究(USENIX Security 2021)は、GPT-2に対する攻撃で1,800件の候補のうち604件が実在の学習データと一致することを確認しました。取り出せた中には、実在の氏名・電話番号・住所・メールアドレスが含まれていました。同じ研究では、学習データに33回出てきた文字列が、最も大きいモデルでは完全に再現できたことも報告されています(出典: Extracting Training Data from Large Language Models(USENIX Security 2021、2021年8月11日〜13日))。
ChatGPTでも同様の検証があります。Google DeepMindのNasr氏らは2023年11月、「同じ単語を延々と繰り返して」という単純な指示で安全対策を回避させ、学習データを再現させました。最も強い条件では、出力の5%超が学習データと50語連続で逐語一致したと報告しています(出典: Extracting Training Data from ChatGPT、2023年11月28日)。
ただし、この手口はその後OpenAI側で対策されています。ふつうの会話でこの規模の再現が起きることはありません。「日常的に起きること」ではなく「起こりうると確認されていること」として認識してください。
学習とは別に、「共有リンク」から読まれた事故は起きている
学習経由ではありませんが、入力した会話が第三者に読まれた事故は実際に起きています。
2025年7月、ChatGPTには共有リンクを検索エンジンで見つけられるようにする試験的な機能がありました。この設定を有効にした会話がGoogleなどの検索結果に載り、第三者から読める状態になっていたと報じられました。OpenAIは2025年にこの機能を撤去しています(出典: Your public ChatGPT queries are getting indexed by Google and other search engines|TechCrunch、2025年7月31日)。
機能は撤去されましたが、共有リンクそのものは今もあります。OpenAIのヘルプセンターは「共有リンクのページは検索エンジンによるインデックス登録を想定していませんが、リンクが非公開になるわけではありません」と説明しています(出典: ChatGPT の共有リンク|OpenAI ヘルプセンター)。リンクを知っている人は、誰でも読めます。
学習させない設定をしていても、共有リンクを作れば話は別です。社内で回すつもりのURLが外に出れば、そこから読まれます。
国内で「他人の回答に出た」と確定した事例は、確認できませんでした
調べた範囲では、日本国内で「入力した内容が学習され、それが原因で他人への回答に出力された」と一次報道で確定した事例は見つかりませんでした。報道の多くは「入力してしまった」段階までです。
ただ、これは安心してよいという話ではありません。問題が起きるのは「④他人への回答に影響する」より先に、「②サーバーに保存される」の時点です。
サムスン電子では2023年3月から4月にかけて、半導体部門の社員が機密のソースコードや社内会議の録音内容をChatGPTに入力し、少なくとも3件の情報漏洩が発覚しました。結果として、生成AIツールの社内利用を原則禁止する通知を出しています。また報道では、共有されたデータがサーバーに保存され、削除やアクセス制御が難しくなる点も懸念として挙げられていました(出典: サムスン、ChatGPTの社内使用禁止 機密コードの流出受け|Forbes JAPAN、2023年5月3日)。
ChatGPTの「学習させない」でつまずく3つの誤解
手順に入る前に、混同されやすい点を整理します。ここを外すと、設定したつもりで守れていない状態になります。
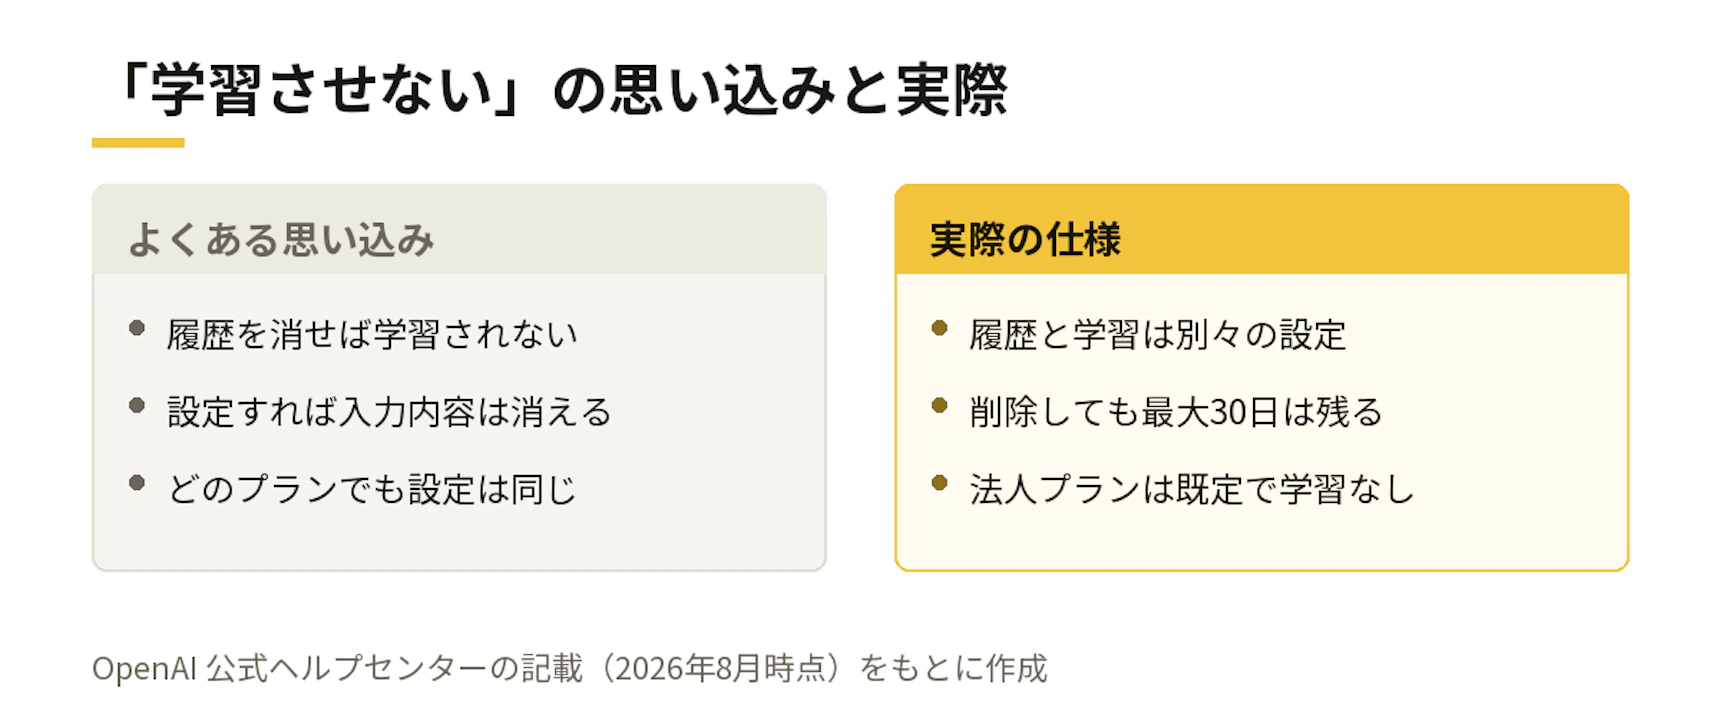
誤解①|履歴を消せば学習されない
履歴の削除と、学習の停止は別の操作です。
混乱の原因は、仕様が変わったことにあります。2023年当時のChatGPTには「Chat History & Training」という1つのトグルがあり、これをオフにすると履歴そのものも消えました。現在は「Improve the model for everyone」という名称に変わり、オフにしても会話は履歴に残ります。日本語表示のアカウントでは「すべての人のためにモデルを改善する」と表示されます(出典: データコントロールに関するFAQ|OpenAI ヘルプセンター)。
OpenAIのヘルプセンターにも「会話は引き続きチャット履歴に表示されますが、ChatGPTのトレーニングには使用されません」と明記されています。
古い解説記事を見ながら設定すると、探しているトグルが見つからず手が止まります。名称が変わっている点にご注意ください。
誤解②|学習をオフにすれば入力した情報は残らない
残ります。チャットは、自分で削除するまでアカウントに保存され続けます。
削除した場合も、画面上はすぐ消えますが、OpenAIのシステムから完全に消えるまでには安全上の理由から最大 30 日間保持される場合があります。法的な保持義務がある場合はこの限りではありません(出典: データコントロールに関するFAQ|OpenAI ヘルプセンター)。
「学習に使われない」と「保存されない」は、別のことです。
誤解③|どのプランでも設定は同じ
プランによって設定方法は違います。ChatGPT Business(旧ChatGPT Team)・Enterprise・APIは、既定で学習に使われません。一方、Free・Plus・Go・Proといった個人向けプランは、オプトアウトしているかどうかで扱いが変わります(出典: 履歴をオンにしたまま、モデルの学習を無効にするにはどうすればよいですか?|OpenAI ヘルプセンター)。
【手順】ChatGPTに学習させない設定方法
ここからは、LLMの中でもChat GPTに学習させない設定方法を紹介します。OpenAIのヘルプセンターは、オプトアウトの方法を2つ示しています。
ChatGPTの「設定」→「データコントロール」で「すべての人のためにモデルを改善する」をオフにするか、プライバシーポータルで「Do not train on my content」を選ぶか。どちらか一方で足りる、と明記されています(出典: モデルのパフォーマンスを向上させるためのデータの使用方法|OpenAI ヘルプセンター)。
具体的な手順を紹介します。(以下は2026年9月時点の手順です)ChatGPTの設定画面は変更が入りやすいため、表示が異なる場合は公式ヘルプの最新版をご確認ください。
①パソコンのブラウザで設定する(ログイン済みの場合)
次の順に操作します。
- 画面のプロフィールアイコンをクリックする
- 「設定(Settings)」を開く
- 「データコントロール(Data Controls)」を選ぶ
- 「すべての人のためにモデルを改善する(Improve the model for everyone)」をオフにする
この設定はアカウント単位です。デバイス単位ではありません。一度オフにすれば、ログインしているすべてのブラウザとアプリに反映されます。OpenAIも「この設定はアカウントに適用されるものであり、特定のデバイスに紐づくものではない」と説明しています(出典: 「すべての人のためにモデルを改善する」設定は Web とモバイル デバイス間で同期されますか?|OpenAI ヘルプセンター)。
パソコンで設定したあと、スマートフォンでも設定し直す必要はありません。
②スマートフォンのアプリで設定する
アプリでは次の順に操作します。
- サイドバーのメニューを開く
- プロフィールアイコンをタップする
- 「データコントロール」を選ぶ
- 「すべての人のためにモデルを改善する」をオフにする
iPhoneとAndroidで手順の違いはありません。公式ヘルプも両者を区別せず、共通の「On Mobile」として同じ手順を案内しています。
③ログインせずに使っている場合
ChatGPTはログインしなくても使えます。この場合の設定手順も、公式ヘルプに「On Web (Signed-out)」として別途用意されています。ログイン済みの場合とは導線が異なるため、データコントロールに関するFAQ|OpenAI ヘルプセンター の該当箇所をご確認ください。
業務利用では、そもそもログアウト状態での利用を避けるほうが管理しやすくなります。誰がいつ何を入力したかを追えないためです。
④この会話だけ学習させたくないとき|一時的なチャット
会話ごとに切り替える方法もあります。「Temporary Chat(一時的なチャット)」です。
新しいチャットを開き、楕円形の「Temporary」ボタンを押すと始まります。一時的なチャットは履歴のサイドバーに残りません。メモリの作成にも参照にも使われず、学習にも使われません。
学習のトグルがオンのままでも、この会話だけを対象外にできます。普段は履歴を残して使いたいが、この1件だけは残したくない、という場面に向いています。
⑤設定画面とは別の入口|プライバシーポータルからのオプトアウト申請
設定画面のトグルとは別に、OpenAIのプライバシーポータル(privacy.openai.com)から申請する方法があります。
ポータルで「do not train on my content」を選ぶと、ChatGPT・Sora・Operatorといった個人向けサービスに適用されます。OpenAIの公式ポリシーには「プライバシーポータルで『do not train on my content』をクリックすることで、学習からオプトアウトできる」「オプトアウトすると、新しい会話はモデルの学習に使われない」と記載されています(出典: モデルのパフォーマンスを向上させるためのデータの使用方法|OpenAI、2026年3月13日更新)。
では、設定画面のトグルとの違いは何か。整理すると次のようになります。
- チャット履歴… 会話を保存するか、消すか。保存の話であって、学習の話ではありません
- データコントロールのトグル… アカウントの設定項目として、学習に使うかどうかを切り替えます
- プライバシーポータルからの申請… 学習に使わないでほしいという意思表示を、申請として記録します
後者2つは、どちらも「学習に使わせない」という同じ結果に向かう入口です。OpenAIのヘルプセンターも、設定のオフとポータルでの選択について「どちらか一方で足ります」と説明しています。
かつて存在した専用のオプトアウトフォームがいつプライバシーポータルへ統合されたのか、明確な日付は公式ページからは確認できませんでした。現在の申請窓口はプライバシーポータルに一本化されています。
⑥法人プランとAPIは、既定で学習に使われない
ChatGPT Business(旧Team)・Enterprise・Edu・APIでは、入力と出力が既定で学習に使われません。APIについては、Playgroundでフィードバックを提供するなど、明示的にオプトインした場合にのみ学習に使われます。組織は既定でデータ共有からオプトアウトされた状態です。
OpenAIのエンタープライズ向けプライバシーページにも「既定では、お客様のビジネスデータをモデルの学習に使用しません」と記載があります(出典: OpenAI におけるエンタープライズプライバシー、2026年1月8日更新)。同ページでは、Business・Enterprise・Healthcare・Edu・Teachers・APIの各プランが対象として挙げられており、SOC 2の監査も完了しているとされています。
1つ注意点があります。OpenAI自身のページでも、プラン名の表記が揃っていません。ポリシーページは2026年3月更新の時点でも「ChatGPT Team」の表記のままですが、エンタープライズ向けプライバシーページは「ChatGPT Business」のみを使っています。社内資料を作るときは「ChatGPT Team(現ChatGPT Business)」と併記しておくと、読む人が迷いません。
⑦Azure OpenAI Serviceを使っている場合
Microsoft経由でOpenAIのモデルを使う場合、データの扱いはMicrosoft側のドキュメントに従います。OpenAIのヘルプセンターではなく、Microsoft Learnを確認してください。
Microsoftのドキュメントによれば、プロンプト・出力・埋め込み・学習データは、顧客の許可や指示なく基盤モデルの学習に使われません。ただし不正利用の監視のために一部データが保存され、人がレビューする場合があります。事前に承認を受ければ「Modified Abuse Monitoring」により、この保存と人によるレビューを止められます(出典: Data, privacy, and security for Foundry Models sold by Azure in Microsoft Foundry|Microsoft Learn、2026年5月更新)。
プラン別|既定の扱いと、学習を止める方法
ここまでの内容を、プランごとに整理します。
| プラン | 既定で学習に使われるか | 学習を止める方法 |
|---|---|---|
| Free / Plus / Go / Pro | オプトアウトしていなければ使われる | 設定 → データコントロール → 「すべての人のためにモデルを改善する」をオフ。またはプライバシーポータルから申請 |
| ChatGPT Business(旧Team) | 使われない | 既定のまま。追加の操作は不要 |
| ChatGPT Enterprise / Edu | 使われない | 既定のまま。追加の操作は不要 |
| API | 使われない(明示的にオプトインした場合のみ使われる) | 既定のまま。入出力は不正利用検知のため最大30日保持され、その後削除される |
| Azure OpenAI Service | 使われない | 既定のまま。不正利用監視の保存と人によるレビューは、承認を受ければ停止できる |
読み取れることは1つです。業務で使うなら、設定を各人に徹底させるより、法人プランに寄せるほうが漏れが起きにくくなります。設定は個人が変えられますが、プランの既定は変わりません。
どのプランに寄せるべきかを自社の使われ方から判断したい場合は、お問い合わせフォームからご相談ください。現在の利用状況をうかがったうえで、移行の順番を一緒に整理します。
オプトアウトにデメリットはあるのか
実害のあるデメリットは、ほとんどありません。よく挙げられる3つのうち2つは、すでにバージョンがアップデートされ改善されています。
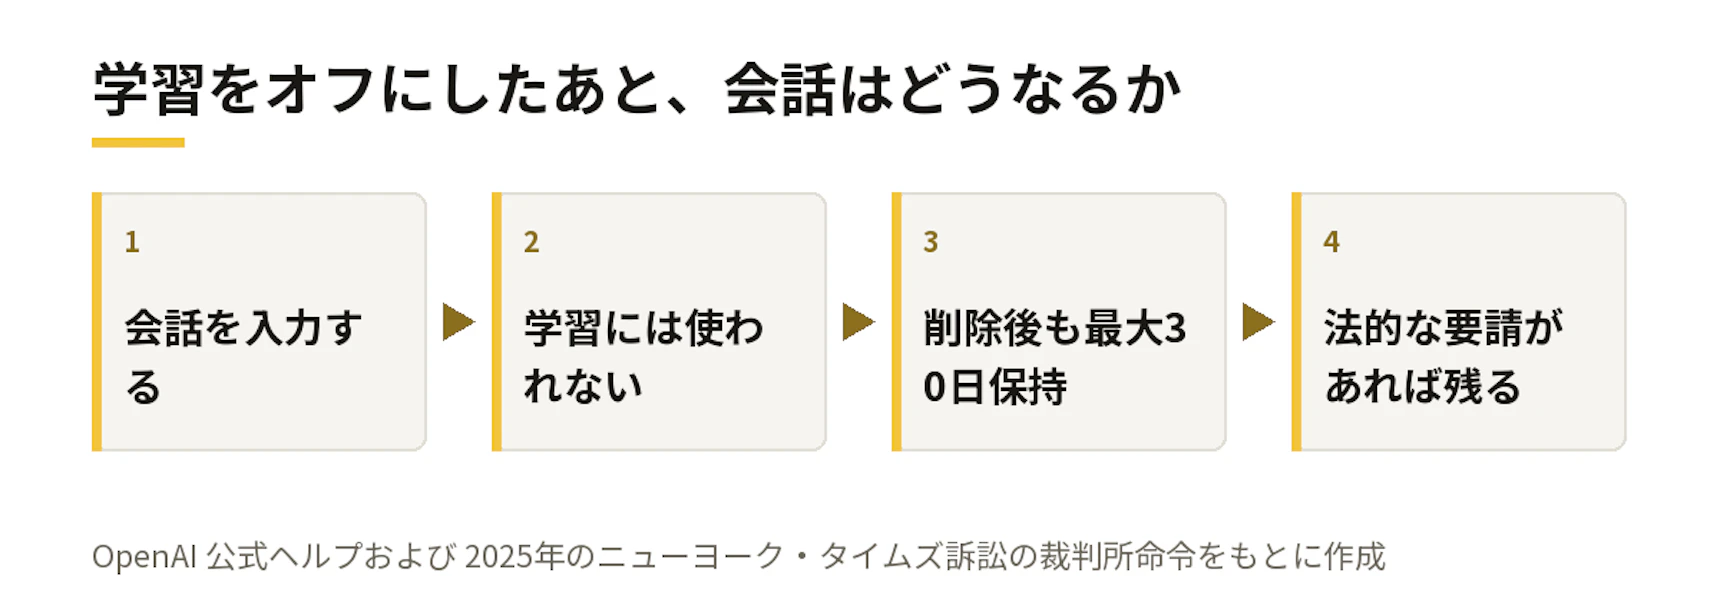
会話は最大30日間システムに残る
先ほど紹介した通り、オプトアウトを設定しても、会話履歴は一定期間(通常は30日間)システムに保存されるため、ユーザーはその点を理解しておくことが重要です。一時的なチャットも、安全確認のために最大30日はコピーが保持されることがあります。しかし、これらのデータは自分で操作をしなくても、30日以内に自動で削除されます。
「入力した直後に消える」わけではない、という点は押さえておいてください。
「過去の全履歴が使えなくなる」は、現在は当てはまりません
現在のChat GPTでは、学習をオフにしても、チャット履歴はこれまでどおり残ります。過去の会話をさかのぼって読むことも、続きから会話することもできます。OpenAIのヘルプセンターも、この設定がオフのとき新しい会話は学習に使われないが、会話はチャット履歴に引き続き表示される、と説明しています(出典: ChatGPT のデータ管理|OpenAIヘルプセンター)。
「回答の精度が落ちる」も、ほぼ当てはまりません
学習のオン・オフは、次のモデルをつくる材料に自分の会話を使うかどうかの設定です。いま自分が受け取る回答の品質を切り替えるものではありません。オフにした瞬間に回答が悪くなる、ということは起きません。
「学習させない設定」だけでは不十分|法令・社内ルールも確認する
生成AIの学習設定をオフにしても、個人情報や機密情報を自由に入力してよいわけではありません。情報の取り扱いには、法律や社内規程、利用サービスの契約条件など、別のルールが関係します。ここでは、公的機関の見解をもとに、生成AIへ情報を入力する際の注意点を整理します。
「学習させない設定」は法律上の免責ではない
個人情報保護委員会は2023年6月2日、OpenAIに対する注意喚起を公表しました。本人の事前同意なく要配慮個人情報を取得しないこと、利用目的を日本語で通知することを求める内容です。あわせて、個人情報取扱事業者と行政機関に向けた注意喚起も出されています(出典: 生成AIサービスの利用に関する注意喚起等について|個人情報保護委員会)。 生成AIに特化した注意喚起としては、2026年9月時点でもこれが最新版です。
ここで注意が必要です。学習をオフにすれば個人情報保護法上も問題がない、とは言えません。
モノリス法律事務所の河瀬季代表弁護士は、生成AIへのプロンプト入力を「委託」として整理することは難しいと指摘しています。委託は、委託元が委託先を監督することを前提とする仕組みです。一般の利用者がAI事業者を監督するのは現実的ではありません。したがって、プロンプトに個人データを入力する行為には第三者提供の規制が及ぶと解したうえで検討すべき、とされています(出典: |モノリス法律事務所 不正競争防止法と個人情報保護法の観点で解説する、生成AIに関する情報管理・漏洩の法的問題)。
牛島総合法律事務所も、入力された個人データが学習用データセットに加工されて機械学習に使われる場合、利用者からAI事業者への個人データの「提供」と評価される可能性が高いとしています(出典: |牛島総合法律事務所 生成AIサービスに関する個人情報保護委員会からの注意喚起と実務への影響)。
設定は必要条件です。十分条件ではありません。
政府機関では、要機密情報の入力自体が認められていない
デジタル庁は2025年2月6日、DeepSeekなどの生成AI利用に関する注意喚起を出しました。その中で、2023年9月15日付の「ChatGPT等の生成AIの業務利用に関する申合せ(第2版)」を改めて示しています。
同申合せは、ChatGPTを約款型クラウドサービスに区分したうえで、約款型クラウドサービスでは原則として要機密情報を取り扱うことはできない、としています(出典: DeepSeek等の生成AIの業務利用に関する注意喚起|デジタル庁、2025年2月6日)。
民間企業に直接適用されるものではありません。ただ、社内規程を作るときの参照点になります。「政府はここまで線を引いている」と示せると、社内の議論が早く進みます。
あわせて参照されるのが、総務省と経済産業省の「AI事業者ガイドライン」です。2024年4月の第1.0版から、2025年3月28日の第1.1版を経て、2026年3月31日に第1.2版が公表されました(出典: AI事業者ガイドライン(第1.2版)|経済産業省)。AI開発者・提供者・利用者の3つの立場に分けて指針を示す構成です。社内規程が第1.0版や第1.1版を参照したままになっていないか、あわせて確認してください。
【対策】業務でChatGPTを使うために決めておく3つのこと
設定の話はここまでです。ここからは、会社として何を決めるかの話をします。
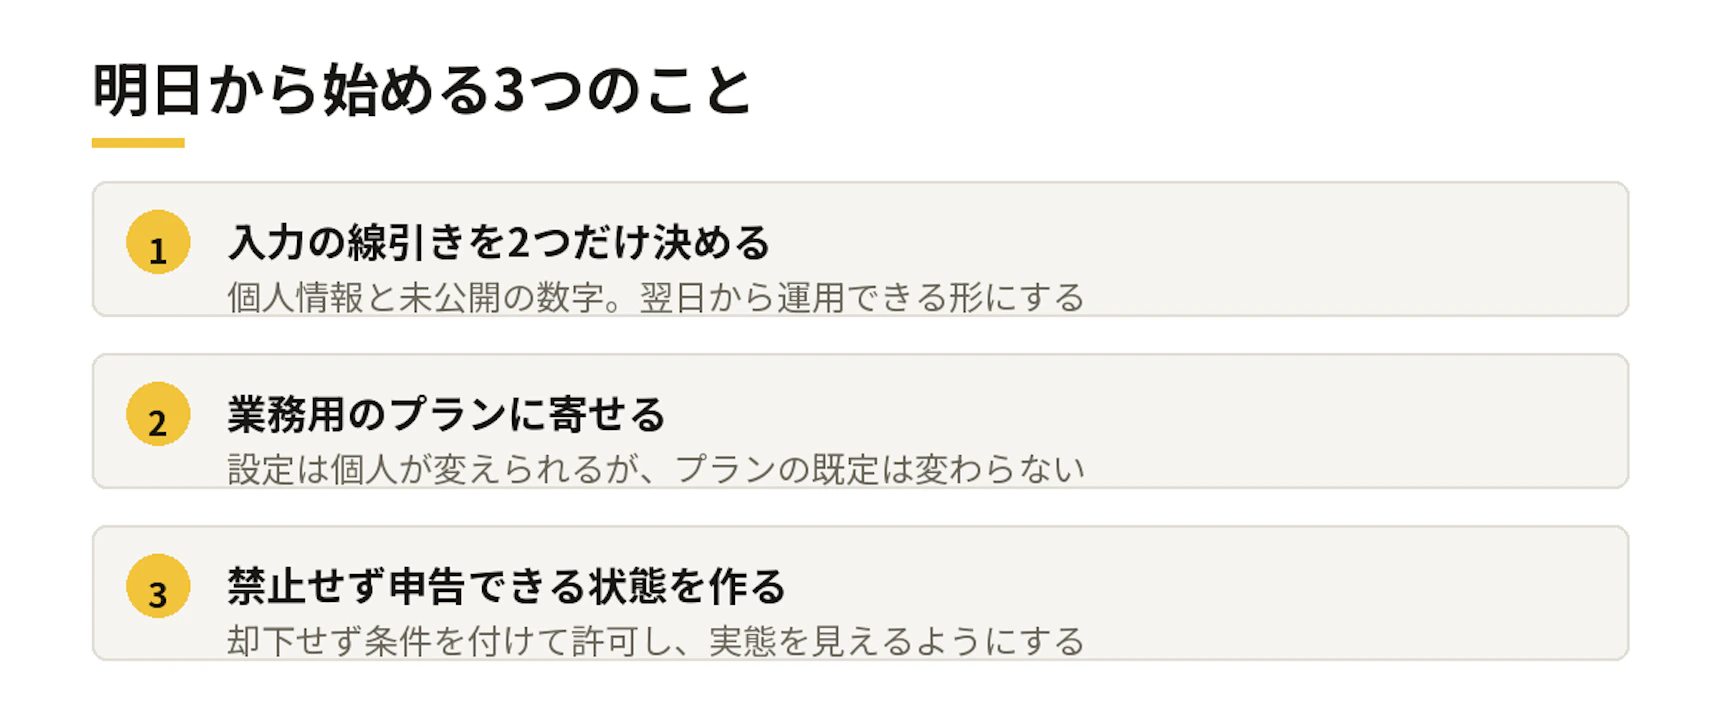
①入力してよい情報の線引きを、先に決める
設定を全社に徹底させるより、入力してよい情報の範囲を決めるほうが先です。設定は変えられますが、入力しなかった情報は流出しません。
先行して決めた企業があります。パナソニック ホールディングスは2023年4月14日、AIアシスタントサービス「PX-GPT」を国内グループ全社員約9万人に展開しました。Azure OpenAI Serviceの法人向けAPIを基盤に構築し、入力した情報が二次利用も第三者提供もされない仕様としています。そのうえで、社内情報・営業秘密・個人情報を入力しないという利用ルールを整備し、全社員に周知したと発表しています(出典: AIアシスタントサービス「PX-GPT」をパナソニックグループ全社員へ拡大|パナソニック ホールディングス、2023年4月14日)。
神奈川県横須賀市も2023年4月18日、自治体として全国で初めて、ChatGPTの全庁的な活用実証を始めると発表しました。入力情報が二次利用されない方式で使い、機密情報や個人情報は取り扱わない運用を徹底するとしています(出典: 自治体初!横須賀市役所でChatGPTの全庁的な活用実証を開始|横須賀市、2023年4月18日)。
決めなかった場合にどういったことが起こるのかの事例として、はじめにも紹介した「サムスン電子」の事例があります。2023年4月、エンジニアが機密のソースコードをChatGPTにアップロードして誤って流出させたことが発覚しました。そこで2023年5月2日までに、社員によるChatGPTを含む生成AIツールの利用を禁止する通知を出しています。同じ時期、Amazonは2023年1月に、JPMorgan Chaseは2023年2月に、それぞれ利用を制限しました(出典: Samsung Bans ChatGPT Among Employees After Sensitive Code Leak|Forbes)。
実践ポイント
全部を決めようとしないでください。最初は2つだけで十分です。
- 個人情報(顧客名・連絡先・従業員情報)は入力しない
- 未公開の数字(売上・原価・見積・未発表の計画)は入力しない
この2つを決めて配れば、翌日から運用できます。網羅的な規程は、運用が始まってから足していくほうが定着します。
実際に起きた流出の事例は、生成AIのリスクとトラブル事例をまとめた記事で詳しく扱っています。社内で説明するときの材料としてお使いください。
②業務用のプランに寄せる
個人向けプランのまま業務で使うと、設定が各人任せになります。誰かが1人オンのままなら、そこから学習に使われます。
ChatGPT Business・Enterprise・API、あるいはAzure OpenAI Serviceであれば、既定で学習に使われません。ニューヨーク・タイムズ訴訟の保存命令でも、EnterpriseとEduは対象外でした。プランの選択が、そのままリスクの差になっています。
実践ポイント
まず棚卸しから始めます。
- 誰が、どのプランで、どの業務に使っているかを一覧にする
- 個人アカウントで業務利用している人を特定する
- その人たちを法人プランに移す。移せない事情があれば、その理由を記録する
一覧を作ると、たいてい想定より使われていることが分かります。そこが出発点になります。
③禁止ではなく、申告できる状態を作る
利用を禁止すると、見えないところで個人アカウントの利用が続きます。会社が把握していない生成AI利用は「シャドーAI」と呼ばれます。
禁止は、リスクを消すのではなく、見えなくするだけです。大企業で実際に起きた無許可利用の事例でも、同じ構図が繰り返されています。
実践ポイント
- 「使ってよいツール」の一覧を作り、増やせる形にしておく
- 一覧にないツールを使いたいときの申請先を1つ決める
- 申請を却下しない。条件を付けて許可する
申告しても損をしない状態を作れば、実態が見えるようになります。見えれば、対策が打てます。
スパイクスタジオの支援事例
三井住友DSアセットマネジメント様では、全社基礎研修と、事務部門での伴走型DX支援研修を実施しました。業務の属人化と、手作業による非効率が課題でした。市場変化のスピードに手作業が追いつかないという状況です。研修では、生成AIへの抵抗感を下げるところから始め、現場の担当者が自分の業務の課題を自分で抽出できる状態を目指しました(導入事例の詳細はこちら)。
トヨタ自動車様では、プロンプト勉強会とプロンプトソンを開催しました。社員の生成AIリテラシーにばらつきがあり、使い方が分からない、使ったことはあるが業務での具体的な活用イメージが持てない、という課題からの取り組みです。
どちらのケースでも、最初に必要だったのはツールの導入ではありませんでした。「何をどこまで入力してよいか」を現場が判断できる状態を作ることです。ルールを配るだけでは、この状態にはなりません。
生成AIの社内ルールづくりは スパイクスタジオにご相談ください
設定のやり方そのものは、この記事の手順どおりに進めればすぐ終わります。難しいのはその先です。誰がどこまで使ってよいかを決め、現場に定着させるところで多くの会社が止まります。
スパイクスタジオは、次のサービスで支援しています。
- AI人材育成… 使う側・作る側・基盤層の三層に分けた研修プログラムです。教育・統制・データ整備をセットで設計します
- BPRコンサルティング… 業務プロセスそのものをAI前提で組み替えます。戦略構想から実行設計まで、実装につながる設計図とロードマップを描きます
- Spike AI Agent Studio… 現場に入り込む専任エンジニアと開発AIがチームになる、月額定額のAIエージェント開発体制です
- ZUNO… 図面・設計・積算など、専門業務のための産業特化型AIエージェントです
「何を入力してよいか、まだ決まっていない」「まず自社の使われ方を把握したい」という段階でも構いません。導入前の不安や課題を一緒に整理するところから始められます。
ご相談はお問い合わせフォームからお願いします。現状をお聞かせいただければ、次の一手を一緒に考えます。